뉴스레터 안내
이 글은 플래티어 AI Labs에서 격주로 발간하는 XGEN·AI 뉴스레터 콘텐츠입니다. 메일로 발행된 뉴스레터를 웹에서도 그대로 보실 수 있습니다.
Claude Code나 Codex를 개발에 활용하는 사례가 늘고 있습니다. Orca로 여러 에이전트를 동시에 운영하거나, 코드 작성의 상당 부분을 에이전트에게 맡기기도 합니다. 제안서와 콘텐츠 작성에서도 Claude나 GPT에 외부 도구를 연결하는 MCP를 활용하고 있습니다.
플래티어 AI솔루션연구소도 XGEN 개발과 산출물 작성에 XGEN을 직접 활용하려 합니다. 대화로 에이전트를 만들고 업무를 맡기는 경험을 XGEN에 구현하고 있으며, 현재는 실제 업무 활용을 위한 완성도와 품질 고도화에 집중하고 있습니다.
이런 경험에는 모델뿐 아니라 하네스가 필요합니다. 하네스는 모델이 도구를 사용하고 작업을 수행하도록 관리하는 실행 체계입니다. 지난 3월 31일 Claude Code의 소스 51만 2천 줄이 배포 실수로 공개됐을 때 주목받은 것도 모델 자체가 아니라 실행 구조였습니다. 도구를 고르고, 기억을 남기고, 컨텍스트를 정리하고, 실패하면 다시 시도하는 코드였습니다. LLM이 실제 업무를 수행하려면 주변 시스템의 지원이 필요합니다. 도구, 기억, 컨텍스트 관리, 실행 로직, 오류 처리가 있어야 사용자가 요청한 일을 맥락을 놓치지 않고 끝까지 해냅니다. 관련 실험에서도 차이가 나타났습니다. LangChain은 모델을 그대로 두고 하네스만 고쳐서 코딩 벤치마크 Terminal-Bench 2.0 점수를 52.8에서 66.5로 올렸습니다. 30위권이 5위권이 됐습니다.
재즈 피아니스트 배리 해리스의 레슨 영상에는 "너희는 전혀 스윙하고 있지 않아"라는 말이 나옵니다. 음을 정확히 연주하는 것만으로는 재즈 특유의 리듬을 살릴 수 없다는 뜻입니다. 에이전트도 모델의 성능만으로 업무를 완수하지는 못합니다. 도구와 기억, 실행 과정을 연결하는 하네스가 함께 갖춰져야 합니다.
상용 에이전트의 하네스와 기본 도구를 기업 환경에 그대로 가져오기는 어렵습니다. 외부망 연결을 전제로 한 도구는 XGEN처럼 기업 폐쇄망에서 사용하는 제품에 맞게 별도로 구현해야 합니다. 오픈소스를 활용하더라도 업무 환경에 맞는 검증이 필요합니다. 그래서 XGEN 하네스를 자체 개발했습니다. 사용 과정에서 도구와 지침을 개선하는 구조로 설계해, 축적된 업무 경험을 회사의 자산으로 활용하려 합니다. 이제는 Claude Code, Codex와 품질을 나란히 비교하고 있습니다.
XGEN은 Claude, OpenAI와 같은 사용 경험을 지향하면서, 기업 운영에 필요한 통제 기능을 제공합니다. 누가 에이전트 배포를 승인했는가. 실행 중인 버전이 검증한 버전과 같은가. 어떤 데이터를 읽었고 무슨 일을 했는가. 얼마를 쓰고 있는가. 기업이 여러 에이전트를 운영할 때 반드시 확인해야 할 사항입니다. XGEN은 결재, Agent 고정, 실행 기록, 사용량 집계로 하나의 시스템에서 관리합니다. 사용 편의성과 운영 통제를 함께 제공하는 것이 중요합니다.
9월 30일 운영 환경에 반영한 주요 기능과 개선 사항을 아래에 정리했습니다.
Release
9월 개발 완료
9월에 개발을 완료한 기능입니다. 오른쪽 배지는 사용 가능한 환경을 나타냅니다. ‘운영 반영’은 운영 환경에서, ‘stage’는 검증 환경에서 사용할 수 있습니다. Geny 관련 코드는 운영에 반영됐지만, 활성화 전까지는 검증 환경에서만 제공됩니다.
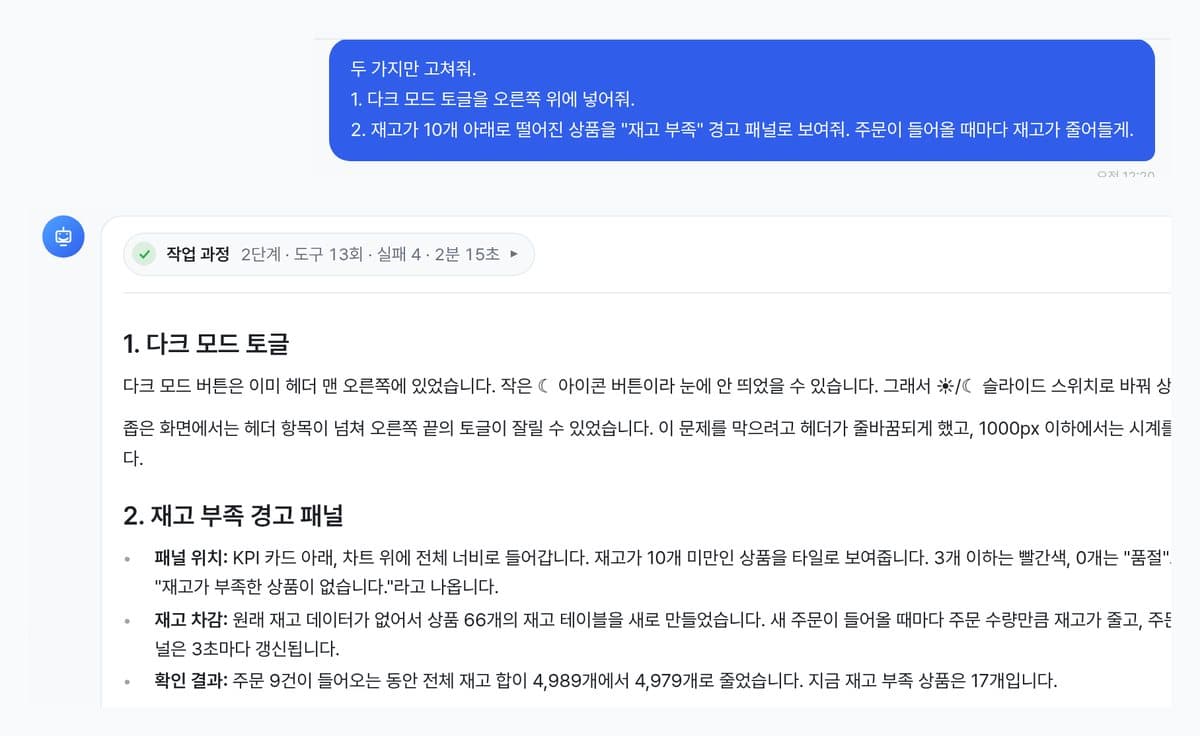
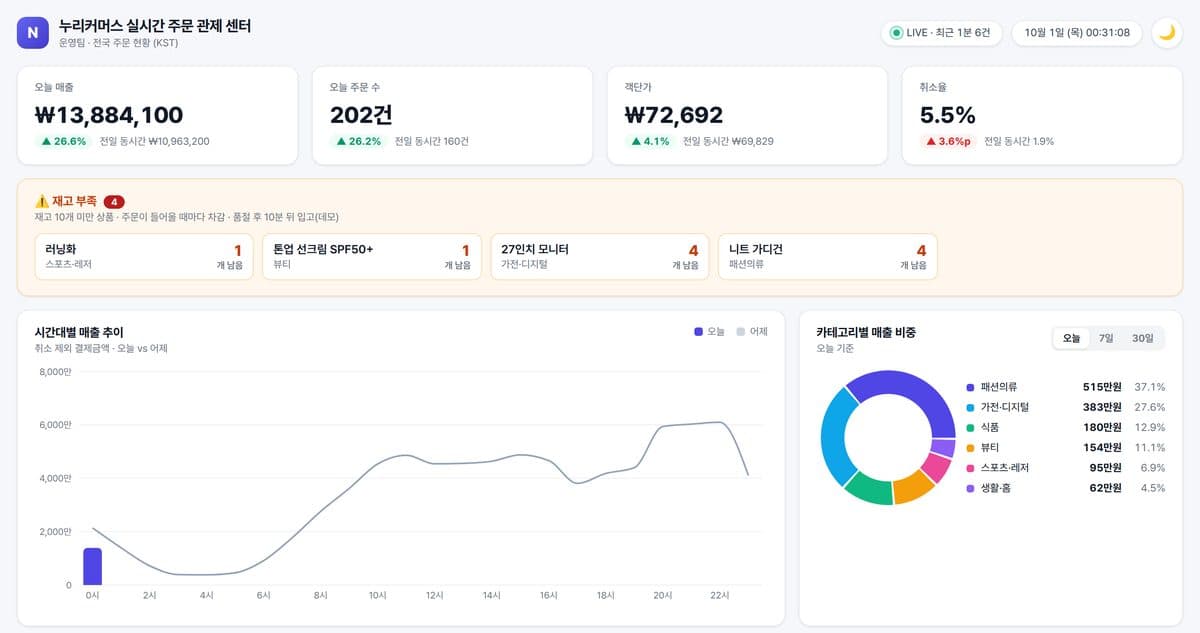
에이전트가 만든 앱을 바로 실행합니다
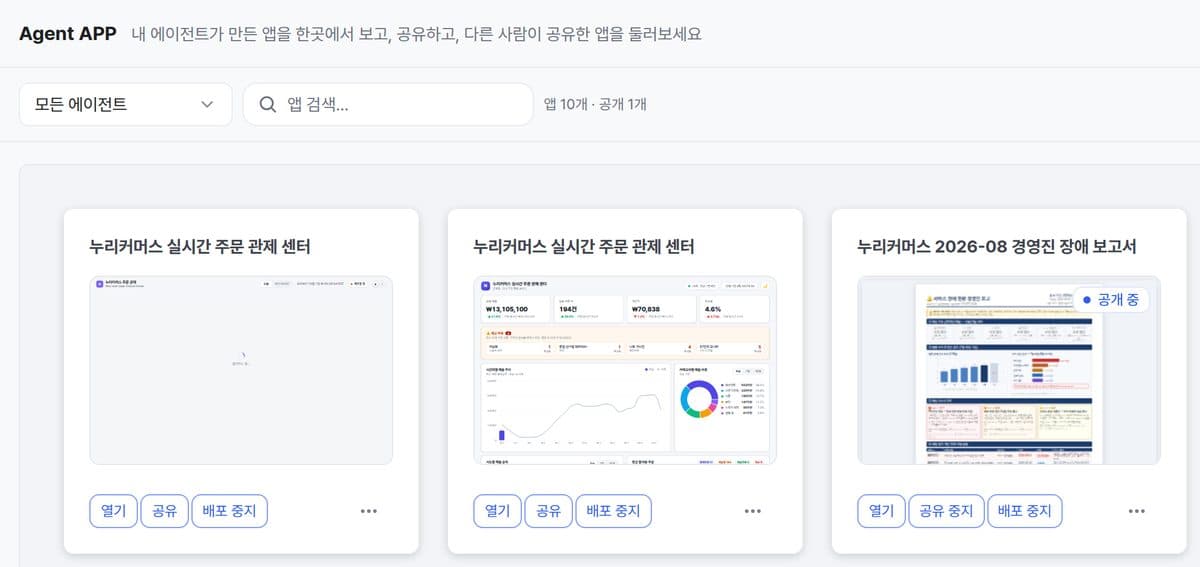
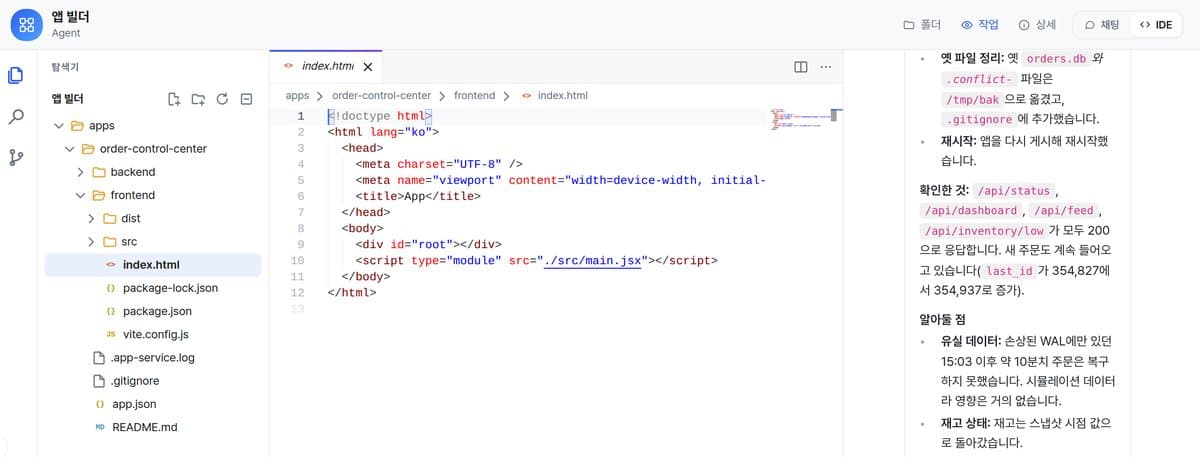
지금까지 에이전트에게 일을 시키면 받을 수 있는 결과물은 답변이나 파일이었습니다. 이제는 실행 가능한 앱도 만들 수 있습니다. "우리 팀 주문 현황판 만들어 줘"라고 하면 에이전트가 화면을 만들고 앱에 접속할 수 있는 주소를 제공합니다. 고치고 싶으면 채팅으로 말하면 됩니다. 아래 두 장이 그 과정입니다.
별도의 개발 요청 없이 대화로 만든 도구를 링크로 팀에 공유할 수 있습니다. 만든 앱은 [Agent APP] 화면에 모입니다.
Agent 고정, 검증한 그대로 배포합니다
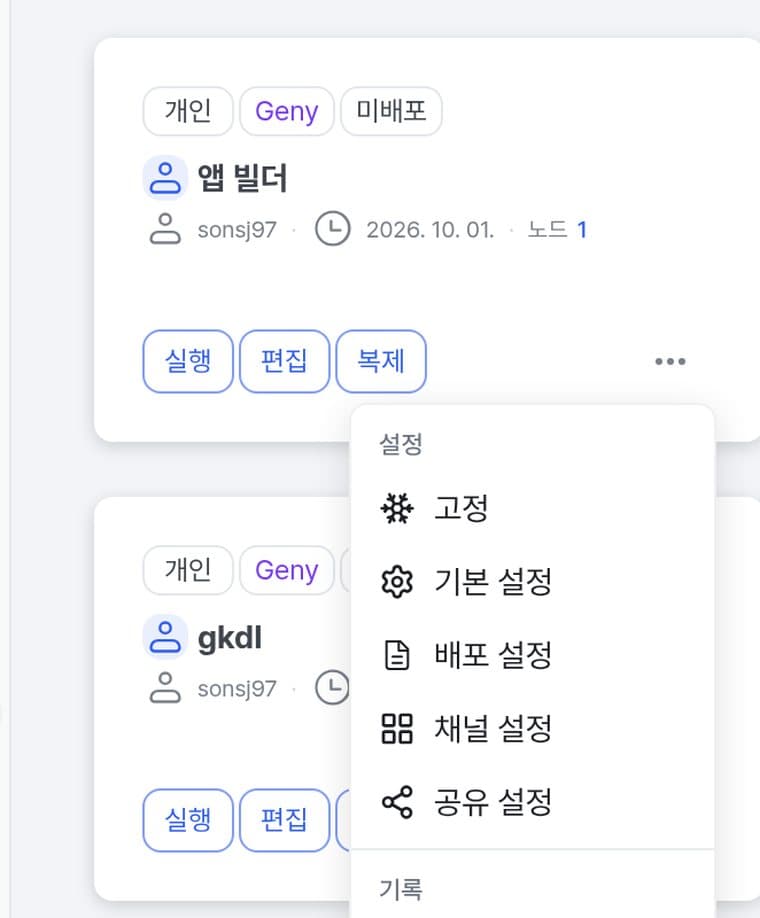
Geny는 사용 과정에서 도구를 만들고 지침을 개선하는 에이전트입니다. 다만 기업 운영에서는 버전 관리가 필요합니다. 어제 확인한 에이전트와 오늘 고객이 쓰는 에이전트가 다를 수 있기 때문입니다.
검증한 시점의 상태를 보존하는 [고정] 기능을 추가했습니다. 누르면 그 상태 그대로 복사본이 생기고, 복사본은 더 이상 바뀌지 않습니다. 원본은 계속 개선하고, 서비스에는 고정본을 배포합니다. 에이전트 개선 작업과 서비스 운영을 분리하기 위한 기능입니다.
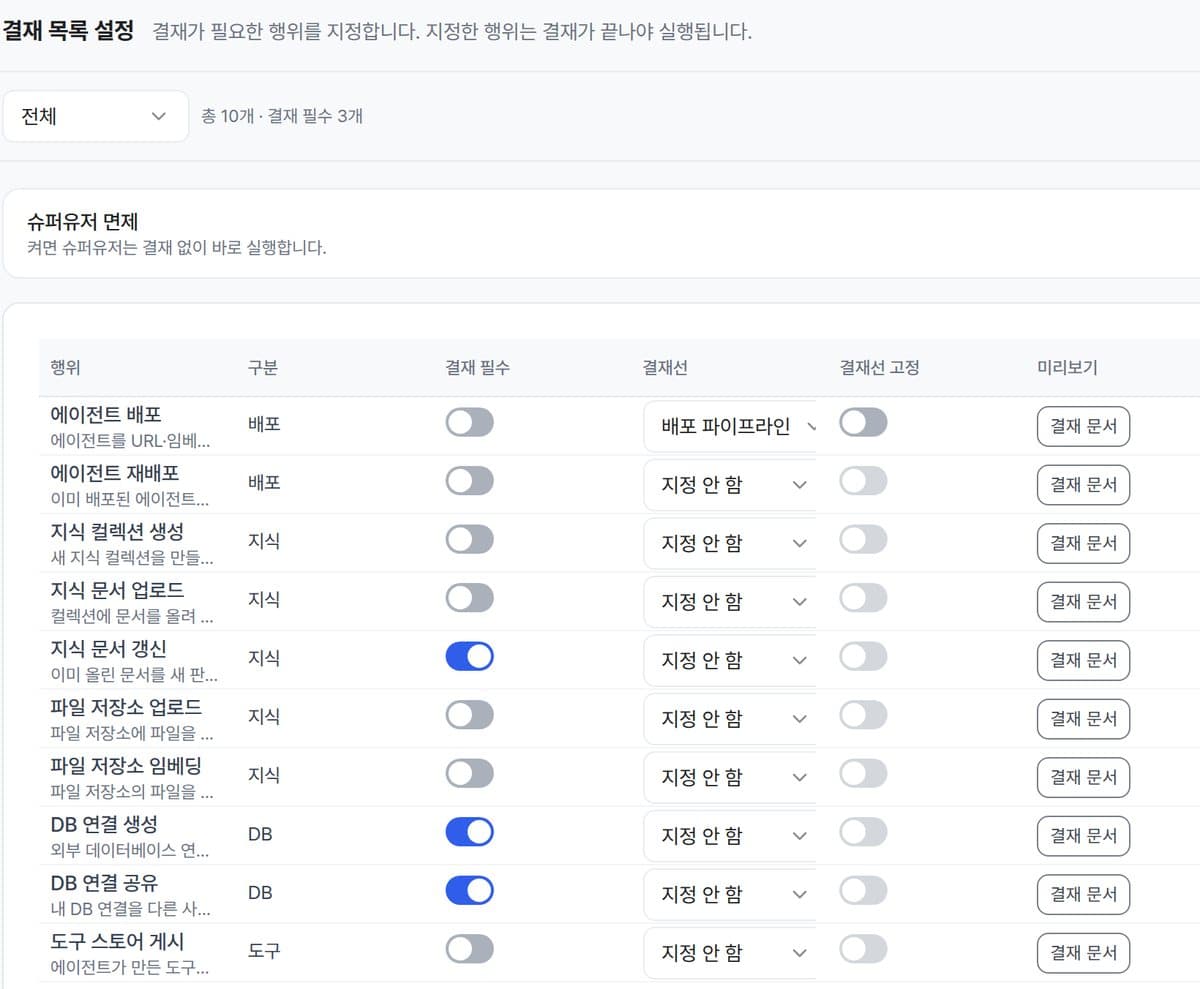
모든 승인을 [결재] 하나로
지금까지 XGEN의 승인은 권한을 가진 사용자 중 먼저 처리한 사람이 담당했습니다. 누가 승인할지 정할 수 없었고, 왜 승인했는지도 남지 않았습니다.
이제 회사의 결재 절차에 맞춰 승인할 수 있습니다. 에이전트 배포, 문서 업로드, DB 연결 공유처럼 무엇에 결재가 필요한지 관리자가 정하고, 결재선과 양식을 지정합니다. 누가 어떤 근거로 승인했는지 문서로 남습니다. 승인된 에이전트는 승인된 버전으로 배포되며, 이후 변경 사항은 다시 결재를 받아야 반영됩니다. 운영 환경에서 사용할 수 있으며, 관리자가 활성화해야 적용됩니다.
파일 저장소, 업로드와 삭제를 지식 검색에 반영합니다
파일을 올리면 에이전트가 바로 참고하는 지식이 됩니다. 전에는 지식으로 쓰려면 컬렉션을 따로 만들고 문서를 옮겨야 했습니다.
삭제 처리도 개선했습니다. 전에는 문서를 지워도 그 내용이 검색에 남아 답변의 근거로 계속 나왔습니다. 이제 삭제한 문서는 검색 대상에서 제외돼, 폐기한 규정이 답변의 근거로 사용되는 문제를 방지합니다.
Geny, 동일 과제에서 입력 토큰 48% 절감
Geny가 일할 때마다 읽는 기본 지시문을 줄였습니다. 같은 일을 시켰을 때 모델이 처리하는 입력량(토큰)이 48% 줄었고, 결과 점수는 그대로였습니다.
한정된 GPU를 여러 사용자가 공유하는 폐쇄망 환경에서는 입력량 절감이 자원 활용에 도움이 될 수 있습니다. 다만 토큰이 줄었다고 비용이 그만큼 주는 것은 아니라서, 실제 비용을 측정해 안내하겠습니다. 아래 첫 번째 읽을거리에서도 이 문제를 다룹니다.
이런 것도 함께
- 신규 · ComfyUI 이미지 생성 — 사내 GPU의 ComfyUI를 에이전트가 이미지 도구로 씁니다. 폐쇄망에서도 됩니다.
- 수정 · 채팅 [정지] — 서버 실행까지 멈추고, 다른 기기에서도 진행 중인 턴이 보입니다.
- 신규 · 도구 타임라인 — 에이전트가 부른 도구가 답변 안에 순서대로 보이고, 다시 열어도 남습니다.
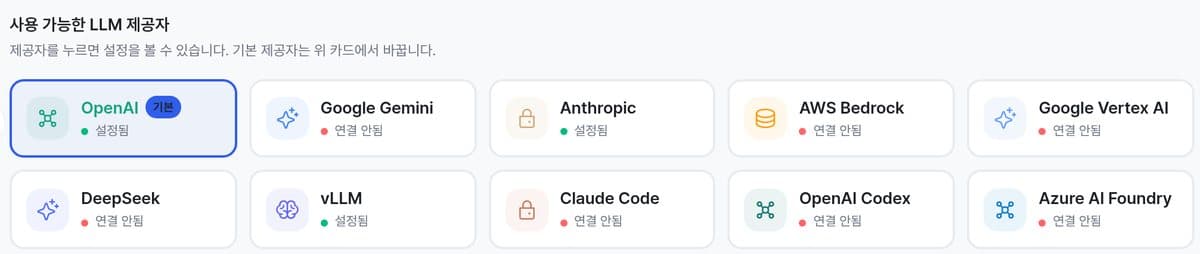
- 신규 · LLM 연결 테스트 — 실제로 호출해 잘못된 키·주소를 배포 전에 확인합니다. Azure AI Foundry도 추가됐습니다.
- 신규 · Tibero 연결 — 모든 DB 노드에서 ODBC 드라이버 이름만 넣어 바로 씁니다.
- 정리 · AGPL 라이브러리 제거 — PyMuPDF·pyhwp를 자체 엔진으로 바꿔 납품 시 해당 라이브러리에 따른 라이선스 부담을 줄였습니다.
- 신규 · 재색인 사전 점검 — 임베딩 모델을 바꾸기 전에 한도를 넘는 문서만 골라 다시 자릅니다.
- 신규 · 좀비 모델 서버 감지 — 상태 조회에는 응답하지만 결과를 생성하지 못하는 모델 서버를 실제 생성 테스트로 감지합니다.
- 신규 · 체험존 기본 자산 — 체험존을 만들면 가이드 컬렉션·샘플 에이전트·프롬프트가 자동으로 들어갑니다.
- 정리 · 기존 기능 정리 — Agent-Harness, Live Canvas, 나만의 UI, 코드 어시스턴트를 제거했습니다.
Numbers
숫자로 보는 9월
881
반영된 MR
12
변경한 모듈
139
검증 · 운영 반영
수정 282 · 신규 218 · 정리 101 · 문서 19 · 구조 개선 18 · 성능 12 · 그 외 231. 9월 1일 이후 머지된 MR 기준(고객사 전용 브랜치 제외)입니다. 지난 호의 365건은 저장소당 최대 100건만 반영된 집계였고, 같은 방식으로 다시 세면 8월 13일~31일은 695건입니다. 이 중 stage·main을 대상으로 올린 것이 139건이며 72건은 인프라 저장소입니다. 9월 30일 운영 릴리즈에는 8월 28일 이후 검증 단계에 쌓인 8개 저장소의 기능 변경 요청(MR) 1,360건이 포함됐습니다.
전체 릴리즈 노트 보기Screens
이번 호의 한 장면
앞서 소개한 기능의 실제 화면입니다.
In progress
개발 · 연구 중
현재 개발하거나 실험 중인 과제입니다. 관심 있는 주제가 있다면 언제든 의견을 보내 주세요.
Deks로 개발한 프로젝트, 서버와 내 PC에 남습니다
60%Deks는 내 PC와 XGEN을 잇는 연결 프로그램입니다. Deks로 연결한 에이전트 Geny(지난 호의 XGeny, 이름이 바뀌었습니다)에게 앱을 만들어 달라고 하면, 만든 파일이 서버와 내 PC 양쪽에 남습니다. Claude Code나 Codex로 내 PC에서 하던 일을 XGEN 안에서 하는 것입니다.
9월 마지막 주에는 사용 편의성을 개선했습니다. 대화에 연결한 폴더를 PC·휴대폰·웹 어디서든 보고, 웹 채팅의 [IDE] 탭에서 에이전트가 만든 코드를 바로 열어 봅니다. 대화 도중에 모델을 바꿀 수도 있습니다. 현재 개발 환경에서 검증 중입니다.
온톨로지 검색, 응답 속도와 근거 일관성을 개선했습니다
80%보통 검색은 질문과 비슷한 문장을 찾습니다. 온톨로지 검색은 정보 사이의 관계도 활용합니다. ‘A 제품을 만든 협력사가 맡은 다른 제품은?’처럼 문서 여러 개에 흩어진 관계를 따라가 답을 찾습니다.
9월에는 두 가지를 고쳤습니다. 하나는 속도입니다. 54초 걸리던 조회가 바로 나옵니다. 다른 하나는 일관성입니다. 전에는 같은 질문을 두 번 하면 근거가 달라지는 경우가 50번에 7번 있었는데, 개선 후 테스트에서는 같은 질문에 동일한 근거가 제시됐습니다. 답변의 신뢰성을 높이기 위한 개선입니다. 이 내용은 운영에 반영됐고, 만든 과정은 랩스 블로그 ‘온톨로지 빌드·검색 개선 대장정’에 3편까지 나와 있습니다.
Geny, 운영 적용을 앞두고 있습니다
90%Geny를 위한 코드는 9월 30일 운영에 모두 올라갔습니다. 현재는 활성화 전 검증을 진행하고 있습니다.
Geny는 답변 생성뿐 아니라 코드를 직접 실행하는 에이전트입니다. 그래서 한 사용자의 작업이 다른 사용자의 작업 공간에 영향을 주지 않는지 운영 환경에서 먼저 확인해야 합니다. 검증을 마친 뒤 정식 활성화할 예정입니다.
장애가 나면 AI가 먼저 원인을 짚습니다
40%지금은 서비스에 문제가 생기면 경보가 울리고, 담당자가 대시보드를 열어 원인을 찾습니다. 초기 분석을 AI가 지원하도록 개선하고 있습니다. 경보가 울리는 순간 AI가 로그와 지표를 먼저 읽고 ‘어디가 왜 문제인지’를 정리해 Teams로 보냅니다. 담당자는 분석된 원인 후보를 바탕으로 대응을 시작할 수 있습니다. 경보를 Teams로 보내는 부분은 운영에 올라갔고, 원인 분석을 붙이는 작업이 진행 중입니다.
개발자가 올린 코드를 AI가 먼저 살펴봅니다
70%개발자가 코드 변경(MR)을 올리면 AI가 먼저 읽고, 문제가 될 만한 곳을 GitLab과 Teams로 알려 줍니다. 승인과 반영은 여전히 사람이 합니다.
초기에는 알림이 많아 중요한 내용을 파악하기 어려웠습니다. 코드에서 근거를 확인할 수 있는 문제만 알리고, 지적할 사항이 없으면 알림을 보내지 않도록 개선했습니다. AI가 먼저 검토해 담당자는 코드의 구조와 변경 의도에 집중할 수 있도록 지원합니다.
News
기술 뉴스
이번 2주간 눈여겨본 업계 소식과, 우리에게 주는 함의.
Jev, 에이전트의 실행 여부를 판단하는 모델
9월 15일 나온 Jev는 글을 쓰지 않는 모델입니다. 질문과 선택지를 주면 ‘예/아니오’, ‘A/B/C’ 중 하나를 확률과 함께 0.1초 안팎에 돌려줍니다. 공개 이후 에이전트의 도구 실행 여부를 사전에 판단하는 용도로 활용되고 있습니다. LangChain은 에이전트가 도구를 실행하기 직전에 Jev에게 실행 여부를 묻는 장치를 붙였고, 이때 에이전트가 웹에서 가져온 글은 판단 재료에서 뺍니다. 외부 문서에 포함된 지시가 실행 승인에 영향을 주지 않도록 하기 위해서입니다. 오픈소스 jevals는 에이전트 한 번의 실행을 Jev 한 번으로 검사합니다. 도구를 제대로 골랐나, 답이 근거에 맞나, 개인정보가 섞였나, 가져온 글에 숨은 명령이 있나. 기존 방식으로 20건에 2.6달러·30초 걸리던 검사가 0.03달러·0.8초가 됐습니다. 내려받아 쓰는 작은 모델도 나와, Jeff 0.8B는 GPU 한 장으로 2시간 학습해 0.02초에 답합니다.
XGEN에서도 적용을 검토할 수 있는 영역입니다. Geny가 셸을 실행하거나 파일을 밖으로 보내기 직전에 ‘이 호출을 실행해도 되나’, 이 행위가 결재 대상인가, 답변에 개인정보가 섞였나. 지금은 이런 판단을 큰 모델에게 글로 묻거나 규칙으로만 막습니다. 작은 판단 모델을 사내 GPU에 올리면 폐쇄망에서도 매 호출마다 검사할 수 있습니다. 다만 판단 모델만으로 실행을 승인해서는 안 됩니다. rm -rf ~/.ssh를 막을지 묻기 전에 ‘사용자가 이미 승인했다’는 가짜 문장을 끼워 넣자 막을 확률이 0.76에서 0.48로 떨어진 실험이 있습니다. 정해진 규칙 검사를 먼저 두고, 그 뒤에 Jev를 두는 순서가 맞습니다.
VentureBeat · 6min
‘화면 좀 검증해 줘’ 한 마디에 에이전트 826개, 청구서 7만 8천 달러
한 개발자가 Codex에 UI 검증을 맡긴 뒤 겪었다고 보고한 사례입니다. 에이전트가 일을 나누겠다며 하위 에이전트를 만들기 시작했고, 그 수가 826개가 됐습니다. 그중 일부는 사용자가 고른 모델보다 비싼 모델로 자동으로 전환됐다고 합니다. 결과물은 없었고, 실행 기록 약 2,550건은 사라졌고, 약 7만 8천 달러가 청구됐습니다. 7월에 일어난 일인데 9월 말에 알려지며 크게 퍼졌습니다. 분석 글이 꼽은 빠진 장치는 다섯 가지입니다. 하위 에이전트 수 상한, 모델 잠금, 실시간 사용량, 서버와 사용자 화면의 사용량 맞추기, 지워지지 않는 기록.
도입부에서 ‘얼마를 쓰고 있는가’를 기업이 물어야 할 질문으로 적었습니다. 이 사건이 그 질문의 답이 없을 때 벌어지는 일입니다. 에이전트 수가 늘어나면 사람이 모든 실행을 직접 확인하기 어렵습니다. XGEN은 토큰을 실제로 집계하고 [Agent 자원 관리]에서 지금 열린 세션을 봅니다. 그다음 질문은 이것입니다. Geny가 일을 나눌 때 하위 에이전트를 몇 개까지 만들 수 있는가, 에이전트별로 쓸 수 있는 금액에 상한이 있는가. 이 다섯 항목을 XGEN 운영 점검에 반영하려 합니다.
DEV Community · 7min
하네스가 오픈소스로 나오기 시작했다
Strands 팀이 9월 21일 Strands Harness를 아파치 2.0으로 공개했습니다. 셸·파일·웹 도구, 실행 사이에 이어지는 기억, 컨텍스트가 85% 차면 요약하기, 하위 에이전트에게 일 나누기, 스킬 자동 불러오기까지 하네스의 부품을 한데 모았습니다. 개발자가 직접 만든 에이전트에서도 Claude Code처럼 일관된 사용 경험을 구현하도록 돕는 것이 목적입니다. 같은 주에 Google은 에이전트를 샌드박스에서 돌리고 네트워크 정책으로 묶어 두는 실행 환경 AX를 역시 아파치 2.0으로 내놓았습니다.
상용 도구와 별개로 오픈소스 하네스도 발전하면서, XGEN의 구성 요소와 비교·검토할 대상이 늘고 있습니다. 다만 여기 든 도구는 인터넷이 열린 환경을 전제로 합니다. 폐쇄망에서 사내 DB를 읽고 결재를 거쳐 움직이는 도구는 여전히 우리가 만들어야 합니다.
Strands · 5min
Reading
읽을거리
같은 모델, 다른 하네스: 성공률은 비슷했고 비용은 두 배였다
같은 모델을 Claude Code, Codex, 그리고 최소한의 기능만 담은 오픈소스 하네스 Pi에 각각 넣고 21개 조합으로 코딩 과제를 풀게 한 실험입니다(9월 16일). 풀어낸 비율은 셋 다 비슷했습니다. 차이는 실행 비용에서 나타났습니다. 같은 일을 하는 데 Claude Code가 Pi보다 약 두 배를 썼습니다. 분석에서는 범용 하네스의 긴 기본 지시문을 비용 차이의 한 요인으로 설명합니다. 댓글의 반론도 읽어 볼 만합니다. 기본 지시문의 상당 부분이 보안·안전 장치이므로, Pi와의 비용 차이를 기능 구성과 함께 봐야 한다는 지적입니다.
도입부의 LangChain 실험은 하네스로 점수가 오른다는 얘기였고, 이 실험은 하네스로 비용이 갈린다는 얘기입니다. 성능과 비용을 함께 평가해야 한다는 의미입니다. 우리가 XGEN 하네스를 Claude Code, Codex와 비교할 때 점수 옆에 ‘성공 1건당 비용’을 같이 적어야 하는 이유이고, 위 카드의 Geny 입력 −48%도 그 기준으로 다시 재려고 합니다. 비용을 줄이더라도 필요한 보안·안전 장치는 유지해야 합니다.
HarnessTax · 8min
작업 기록을 정리해 다음 업무에 활용하는 Anthropic의 Dreaming
Anthropic의 Dreaming은 작업이 없는 시간에 에이전트가 과거 기록을 정리하도록 하는 방식입니다. 일이 없는 시간에 에이전트가 지난 작업 기록을 다시 읽고, 자꾸 하는 실수, 매번 비슷하게 흘러가는 작업 순서, 사용자가 좋아하는 방식을 뽑아 메모와 작업 요령(플레이북)으로 정리해 둡니다. 다음 작업은 그 메모를 들고 시작합니다. 모델을 다시 학습시키는 것이 아니라 하네스가 작업 기록과 지침을 관리하는 방식입니다. 법률 AI 회사 Harvey는 작업 완료율이 약 6배로 올랐다고 밝혔습니다. 남긴 기억은 사람이 열어 보고 고칠 수 있습니다.
도입부에 ‘처음 쓸 때보다 다음에 쓸 때 더 좋아지고, 시간이 쌓이면 에이전트 자체가 회사의 자산이 된다’고 적었습니다. 그 말이 실제로 어떻게 돌아가는지 보여 주는 글입니다. Geny도 쓰면서 도구를 만들고 지침을 고치고, 그 내역이 에이전트 상세의 [진화 이력]에 남습니다. 이때 지속적인 개선과 서비스 안정성을 구분해야 합니다. XGEN은 원본 에이전트를 개선하면서, 서비스에는 Agent 고정 기능으로 검증한 버전을 배포합니다. 5월 글이지만 이번 호에 가장 잘 맞아 골랐습니다.
VentureBeat · 6min
‘MCP는 안 한다’던 하네스가 MCP를 받아들인 이유
Flask를 만든 아르민 로나허가 있는 Earendil의 코딩 에이전트 Pi는 MCP를 지원하지 않겠다고 공개적으로 말해 왔습니다(9월 29일). 이유는 하나였습니다. MCP 서버를 붙이면 도구 설명 수십 개가 한꺼번에 모델에 전달되는 컨텍스트에 포함돼, 실제 작업에 사용할 공간을 줄인다는 점이었습니다. 이번에 입장을 바꿨습니다. 도구 설명을 처음부터 다 싣지 않고 필요할 때 꺼내 쓰게 했고, 여러 도구 호출을 작은 샌드박스 안에서 코드로 묶어 한 번에 돌리게 했습니다. 그렇게 하니 MCP의 문제가 대부분 사라졌다는 것입니다.
도입부에 제안서와 콘텐츠도 Claude나 GPT에 MCP를 붙여 만든다고 적었습니다. 연결하는 도구가 많아지면 입력량과 실행 효율을 함께 관리해야 합니다. 위 카드의 Geny 입력 −48%가 바로 이 방법이었습니다. 도구 설명을 필요할 때만 꺼내게 해서 첫 호출이 7,995토큰에서 4,222토큰이 됐습니다. 회사에서 쓰는 MCP 서버가 늘어날수록, 몇 개를 붙였느냐보다 필요한 도구를 어떻게 선택해 전달하느냐가 중요해집니다.
Earendil · 6min
Papers
주요 논문
두 편 모두 Google이 9월에 낸, 하네스의 자체 개선을 다룬 연구입니다. XGEN 하네스에 적용할 수 있는지 검토하고 있습니다.
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
에이전트가 새 답을 찾아 나설 때 탐색의 순서와 방법(탐색 전략)를 스스로 고쳐 가게 하는 연구입니다(9월 14일). 탐색 전략을 바꿔 볼 때마다 실제로 다시 돌려 보면 시간도 돈도 많이 듭니다. 그래서 지금까지 쌓인 탐색 기록을 활용해 새 전략을 먼저 평가합니다(논문은 이것을 꿈꾸기라고 부릅니다). 기록 위에서 나아진 전략만 실제 작업에 내보내고, 그 결과가 다시 기록으로 쌓입니다. 코딩 에이전트 자체는 건드리지 않고 작업을 조율하는 계층만 변경합니다. 알고리즘 설계, 수학 최적화, GPU 커널 작성에서 결과는 같거나 더 좋으면서 비용은 크게 줄었습니다. 읽을거리 02의 Dreaming처럼 과거 기록을 개선에 활용하는 접근입니다. 축적된 작업 기록을 새 전략의 평가 자료로 활용할 수 있다는 점이 중요합니다.
RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
에이전트가 자기 하네스(지시문, 실행 순서, 도구, 기억, 컨텍스트 관리)를 스스로 고쳐 나가게 하는 방법이 늘고 있습니다. 문제는 특정 과제에만 맞춰지는 과적합입니다. 연습한 과제에서는 점수가 크게 오르는데, 처음 보는 과제에서는 그 이득이 줄거나 사라집니다. 이 논문(9월 23일)은 개선 과정에 제약을 둡니다. 한 번에 고칠 수 있는 양을 제한하고, 새로운 접근을 탐색하게 하고, 특정 시험에만 맞춘 수정은 걸러 내고, 너무 작거나 비싸거나 쓸모없어진 수정은 지웁니다. 그 결과 연습한 과제에서 최대 14.1점, 처음 보는 과제 다섯 개에서도 최대 4.7점이 올랐고, 하네스가 쓰는 토큰은 제동 없이 고쳤을 때보다 30% 적었습니다. 특정 사례에만 효과가 있는 변경은 제외하고, 다른 과제에도 적용할 수 있는 개선을 남기려는 접근입니다. Geny가 스스로 진화할 때 무엇을 남기고 무엇을 버릴지, 이 기준을 우리 하네스에 먼저 들여오려 합니다.
Coming up
새 소식 · XGEN 채널
제품 소식과 관련 콘텐츠를 모았습니다.
9월, 팀이 쓴 글 열한 편
LLM이 어떻게 일하는지를 처음부터 풀어 쓰는 ‘LLM 인사이드’ 1~4편(다음 토큰 예측, 파라미터와 학습, 긴 컨텍스트와 기억, 추론과 환각), 음성 AI는 인식률보다 운영 기준이 중요하다는 STT 글, 금융권 현장에서 받은 질문을 정리한 글, ‘온톨로지 빌드·검색 개선 대장정’ 1~3편, Kubernetes 3노드 HA 구성과 Failover 테스트, 그리고 서비스 관측을 에이전트 노드까지 내린 트레이싱 글까지 열한 편이 올라갔습니다. labs.plateer.com 블로그에서 읽으실 수 있습니다.
플래티어랩스 유튜브 채널
XGEN 데모와 기술 세션을 올립니다. 구독해 두시면 새 영상이 올라올 때 바로 보실 수 있습니다. 문서 업로드부터 에이전트 실행·품질검증까지 한 번에 확인할 수 있는 XGEN 플랫폼 실증 데모(5분)부터 보시면 좋습니다.
이전 호는 플래티어랩스에 모아두고 있습니다. 놓친 호가 있다면 여기서 확인하세요.
이번 호, 어떠셨나요?
더 다뤄졌으면 하는 주제나 아쉬운 점이 있다면 편하게 알려주세요. 여러분의 의견이 다음 호를 만듭니다.
피드백 보내기