
편집자 노트 · B2B 고객 관점 — 고객이 확인하려는 것은 로그의 양이 아니라, 업무가 지연되거나 실패했을 때 원인을 어디까지 추적하고 대응할 수 있는가입니다. 이 기고는 서비스 수준의 모니터링을 넘어 에이전트의 노드·모델·도구 호출 단위까지 실행 과정을 추적하는 운영 경험을 다룹니다. 도입을 검토할 때는 대시보드 제공 여부뿐 아니라 장애 발생 시 원인 추적 가능성, 경보의 정확성, 민감정보 수집 범위, 운영 주체와 책임 체계까지 함께 살펴보시기 바랍니다.
AI 에이전트 워크플로우, 노드 단위 추적의 공백
저는 이전 L홈쇼핑 인프라를 구축하며 기존 XGEN에는 메트릭·로그 수집은 잘 구성되어 있는 반면 트레이스 지표 수집은 다소 부실하다고 판단했습니다. 따라서 해당 인프라에 OTel과 Jaeger UI 기반으로 분산 추적 시스템을 실험적으로 도입해봤습니다. 이러한 분산 추적 시스템 도입은 방향 자체는 올바르다고 판단하고 있습니다. 다만 현장에 더 오래 머무르며 요구사항을 생각해봤을 때 얼마간 미흡한 점이 없잖아 있었습니다.
가장 큰 문제는, 현장에서는 엔터프라이즈 AI 에이전트 솔루션이라는 제품 특성상 에이전트 워크플로우가 느릴 때 왜 느린지, 실패할 때 왜 실패하는지에 가장 큰 관심을 기울인다는 점이었습니다. OTel 자동계측은 HTTP·DB 같은 표준 경계로 계측 단위를 카운트합니다. 물론 이것만으로도 흔한 CRUD 단위 API 병목을 잡을 수는 있습니다. 하지만 AI 에이전트 워크플로우/노드라는 특성화된 단위의 계측이 이뤄지지는 않아 "어느 노드가 느렸는지", "어느 노드에서 실패했는지" 같은 질문에는 답변할 수가 없었습니다.
동일한 이슈를 이전 J은행 프로젝트의 요구사항에서도 확인할 수 있었습니다. 해당 고객사의 요구사항에는 "Agent 노드 실행 오류 감지", "MCP 도구 실행 실패 감지", "타임아웃 발생 감지" 같은 항목들이 포함되어 있었는데 대응 방식은 "로그화면 제공"으로 갈무리되어 있었으며, 어느 노드에서, 어느 단계에서 발생한 오류인지를 어떤 구조로 보여줄지는 정의돼 있지 않았습니다.
결국 L홈쇼핑도, J은행 프로젝트도 같은 문제를 드러내며, 관측성 차원에서 제품이 나아가야 할 방향을 뚜렷하게 가리키고 있었습니다. 서비스·인프라 레벨 관측은 확보됐거나 확보할 수 있지만, "노드 단위 실행 경계"만큼은 애플리케이션 코드 안에서 직접 계측하지 않는 한 만들어지지 않는다는 것이었습니다. 그렇다면 여타 다른 솔루션에서는 이걸 어떻게 해결하고 있을지가 궁금했습니다.
노드 단위 트레이싱, n8n의 사례
이에 관해 서치를 하다가 제가 참고한 게 범용화된 오픈소스 에이전트 n8n이었는데, 공식 매뉴얼을 확인해보니 n8n에는 워크플로우를 노드 단위로 추적하는 문제에 대한 나름의 가이드라인이 이미 마련되어 있었습니다. n8n은 workflow.execute span 안에 노드마다 node.execute span을 중첩시켜 보내며, 노드 ID·이름·입출력 항목 수 같은 속성까지 함께 실어 OTLP로 내보냅니다. 사용자 입장에서는 이를 Grafana Tempo든 Jaeger UI든 원하는 백엔드에 붙이면 그대로 조회할 수 있으며, 에이전트 기능을 사용한다면 execute_tool span까지 자동으로 붙어 Tool Call 단위까지 추적되며, 노드가 실패하면 그 span에 exception까지 기록돼 실패한 노드 하나로 원인을 바로 좁힐 수 있었습니다. 저는 저희가 겪은 이슈를 해결하기 위해 n8n의 사례를 참고할 만하다고 생각했습니다.
from service.observability import (
    SPAN_WORKFLOW_EXECUTE, Kind as SpanKind,
    end_span, fail_span, hash_identifier,
    set_attributes, start_span,
)
from service.observability import attributes as otel_attrs

_wf_span = start_span(
    SPAN_WORKFLOW_EXECUTE,
    kind=SpanKind.INTERNAL,
    attributes={
        otel_attrs.XGEN_WORKFLOW_ID: workflow_id,
        otel_attrs.XGEN_WORKFLOW_NAME: workflow_name,
        otel_attrs.XGEN_INTERACTION_ID: interaction_id,
        otel_attrs.XGEN_EXECUTION_MODE: (
            "sub_workflow" if workflow_call_stack else "root"
        ),
        otel_attrs.ENDUSER_ID: hash_identifier(user_id),
        otel_attrs.XGEN_OWNER_ID: hash_identifier(owner_id),
    },
)
AI 에이전트 분산 추적 아키텍처 전략 세우기
저희가 참고할 지점은 명확했습니다. 워크플로우·노드 실행이라는 도메인 경계는 표준 계측만으로는 잡히지 않으니, OTel SDK로 코드 안에서 직접 커스텀 span을 열어야 한다는 방향성이었습니다. 따라서 저는 service.observability라는 단일 진입점 패키지의 start_span/end_span 래퍼로 워크플로우·노드 단위 span을 코드 안에서 직접 열고, 그 span에 workflow_id, interaction_id, 실행 모드 같은 XGEN 커스텀 속성까지 함께 실어 노드 단위 추적의 근거를 확보하도록 OTel의 Manual Instrumentation을 설계했습니다.
다만 이것만으로는 부족했는데, 결정적으로 다른 점이 한 가지 있었기 때문입니다. 모놀리식 아키텍쳐에 근간을 두는 n8n은 워크플로우 실행이 단일 프로세스 안에서 끝나는 구조였지만, XGEN은 MSA 아키텍처로 구성돼 있어 워크플로우 하나가 xgen-workflow → xgen-document, 혹은 xgen-workflow → xgen-mcp-station처럼 여러 서비스를 횡단하며 호출되는 경우가 더러 있습니다. 따라서 노드 단위 수동 계측만 먼저 넣으면, 정작 서비스 경계를 넘는 순간 Trace Context가 끊겨버릴 위험이 있었습니다.
이 공백을 메우기 위해 Manual Instrumentation에 앞서 Zero-code Instrumentation을 먼저 깔았습니다. 쿠버네티스 클러스터에 OTel Operator를 배포해 Pod 단위 자동 계측 주입을 위한 컨트롤 플레인부터 구성하고, Python 런타임을 Auto Instrumentation 대상으로 등록했습니다. 이후로는 대상 워크로드에 instrumentation.opentelemetry.io/inject-python: "true" annotation 한 줄만 추가하면, Operator가 사이드카·init container로 계측 라이브러리를 자동 주입해 코드 변경 없이 HTTP·DB 같은 표준 경계에 span이 생성됐습니다. 에이전트 코드를 한 줄도 건드리지 않고 클러스터 전역에 깐 이 기본 배관 위에서, 비로소 OTel SDK 기반 Manual Instrumentation으로 워크플로우·노드 단위 span을 얹는 2단계 아키텍처가 완성됐습니다.
노드 단위 계측, 코드로 실체화하다
설계도를 그렸으니, 이제 이걸 실제 코드로 옮길 차례였습니다. 붙이면서는 몇 가지가 더 필요했습니다.
opentelemetry를 직접 import하는 파일은 otel.py, instrument.py, context.py, spans.py 네 개로 못박고, 나머지는 전부 service.observability 패키지만 참조하게 했습니다. 덕분에 tracing이 꺼진 환경에서도 헬퍼가 no-op으로 동작해 애플리케이션 동작은 그대로 유지됐습니다. auto-instrumentation과의 역할 분담도 다시 잡았습니다. TracerProvider를 직접 만들면 opentelemetry-instrument 에이전트가 구성해둔 provider와 충돌했기 때문에, provider가 있으면 따르고 없을 때만 fallback을 구성하도록 바꿨습니다. threading instrumentation도 필수였습니다 — 워크플로우 노드가 워커스레드에서 실행되다 보니, 꺼져 있으면 node.execute 이하가 고아 trace로 흩어졌습니다.
최종 span 계층은 이렇게 정리됐습니다.
workflow.execute
└─ node.execute
   └─ invoke_agent {agent}
      ├─ chat {model}
      ├─ execute_tool {tool}
      └─ retrieval.search
생명주기는 _closed 플래그 대신 AgentTurnSpan/OutcomeSpan/ToolSpanTracker 객체가 관리하도록 바꿨습니다. 조기 반환 경로가 많은 함수에서 플래그를 놓치는 실수를 없애기 위해서였습니다. 취소와 실제 오류도 구분해, 사용자가 스트림을 끊은 것과 장애가 화면에서 섞이지 않게 했습니다. 실행 경로가 신규 런타임과 LangChain 기반 두 갈래로 나뉜 문제는 두 경로가 공통으로 거치는 기존 TraceCollector에 AgentTraceBridge를 붙여 풀었습니다. 덕분에 나중에 에이전트 구현이 외부 라이브러리로 바뀌어 로컬 계측 코드가 사라졌을 때도 span 계층에 구멍이 나지 않았습니다. 마지막으로 safe_attributes() 필터로 api_key·token·credential 같은 키는 무조건 제외하고, prompt·response 계열은 캡처 플래그가 꺼져 있으면 걸러내도록 했습니다.
쌓인 Trace를 대시보드와 경보로 연결하기
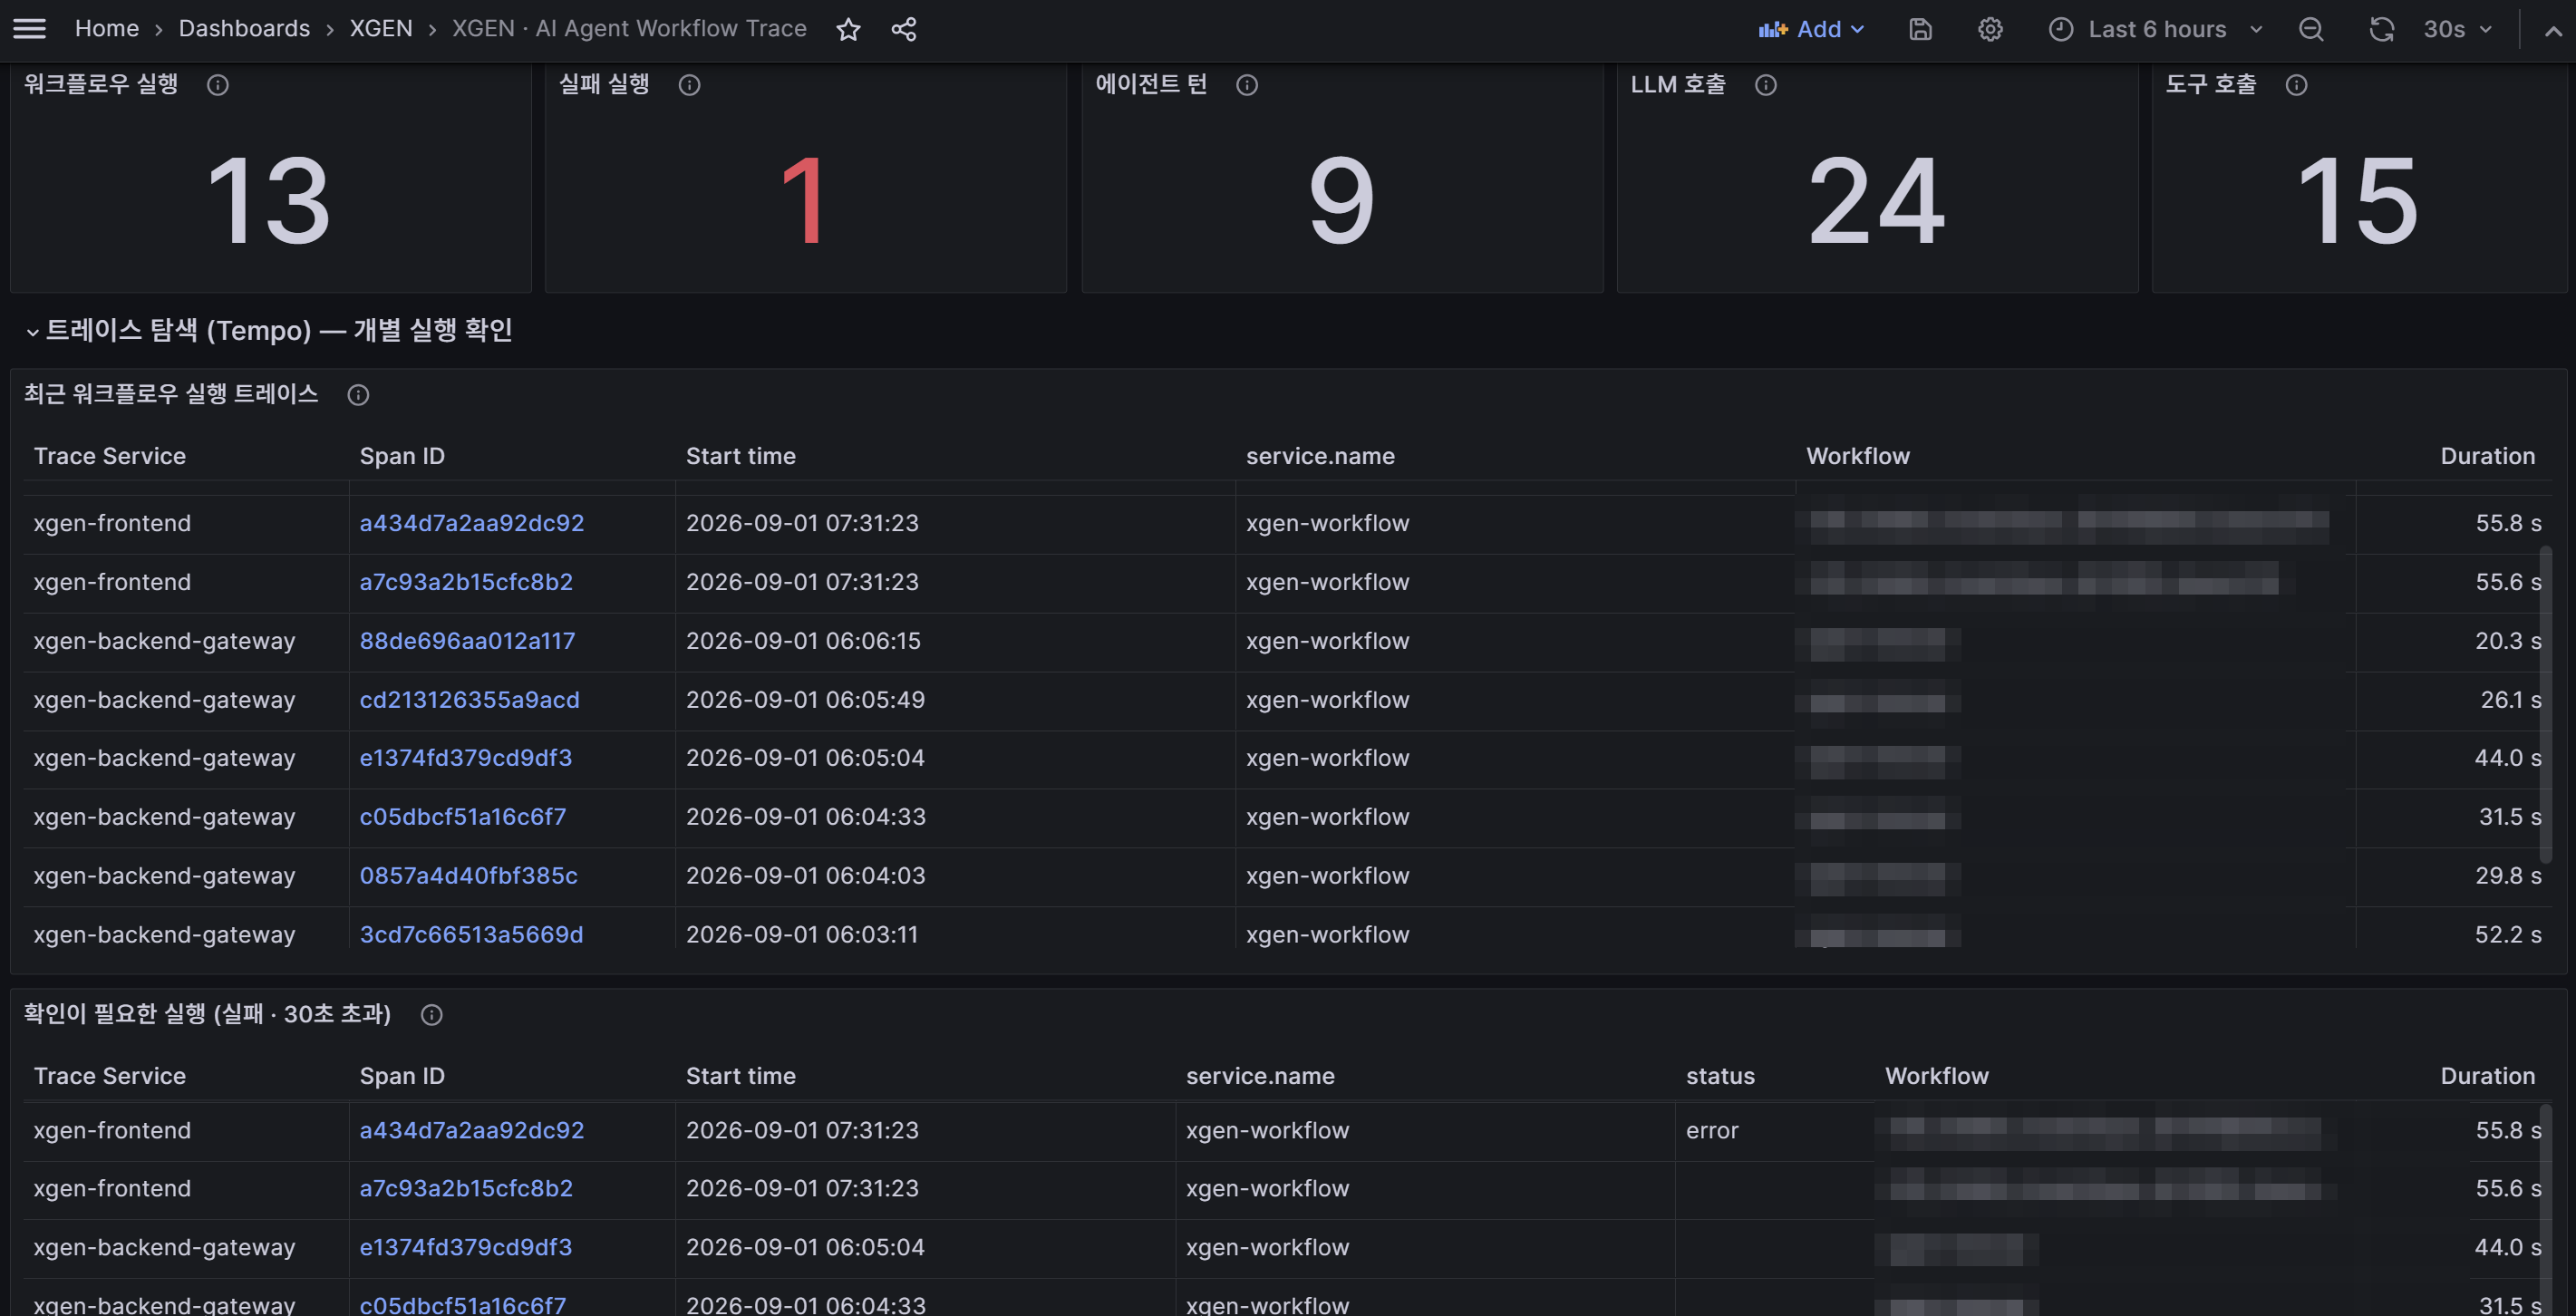
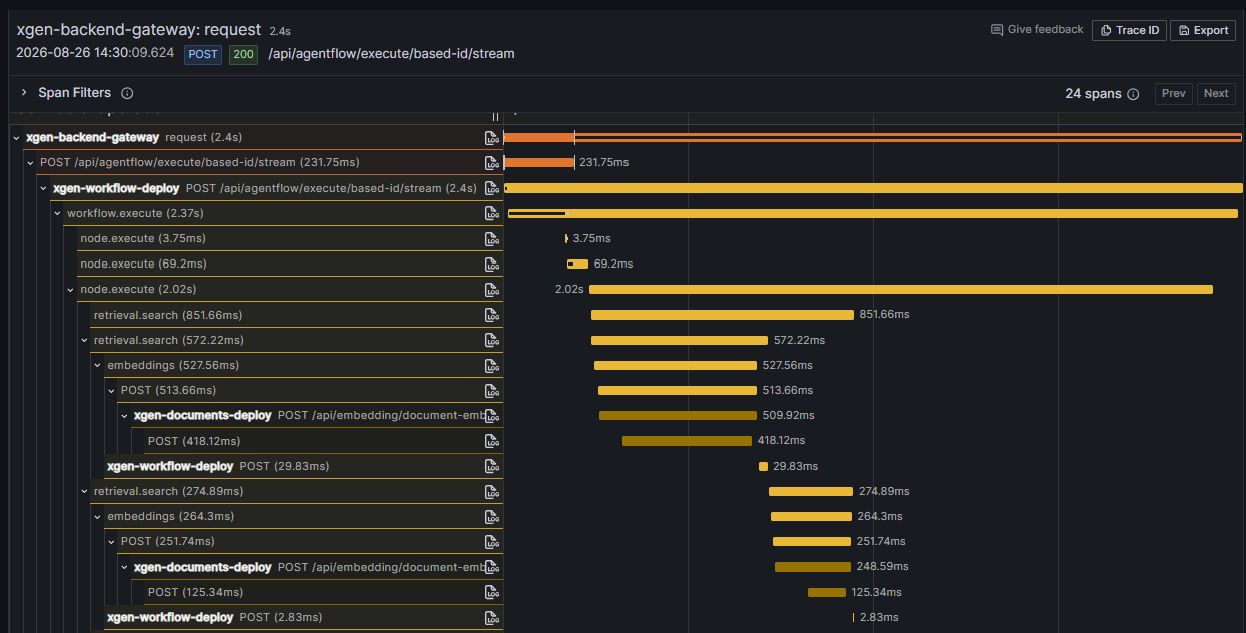
앞서 코드와 아키텍처 레벨에서 분산 추적을 구현했다면 이제 이를 가시화하여 보여줄 UI를 채택해야 했습니다. 이미 한 번 사용한 적 있는 Jaeger UI는 별도 쿼리 언어 없이 폼으로 검색할 수 있고 서비스 의존성 그래프까지 기본 제공해 진입장벽이 낮은 편입니다. 다만 독립 실행형 도구라 메트릭·로그를 보려면 이미 소스로 포함된 Grafana와 별개로 화면을 옮겨 다녀야 했습니다. Grafana Tempo는 TraceQL을 새로 익혀야 하고 별도 인덱스가 없어 속성 기반 검색은 Jaeger보다 제한적입니다. 하지만 이미 쓰고 있는 Grafana 생태계 안에서 로그·메트릭과 한 화면에 묶이고, 워크플로우·에이전트 턴·도구 호출 같은 지표를 원하는 패널로 직접 짜 넣는 커스텀 대시보드까지 만들 수 있다는 이점이 있습니다. 결과적으로 저는 이 중에서 Grafana Tempo를 선택했습니다. 이미 Grafana를 메트릭·로그 대시보드로 쓰고 있어 같은 화면에 바로 이어붙일 수 있었고, Grafana Alerting으로 AI 에이전트 워크플로우 경보까지 트리거할 수 있으며, Jaeger UI보다 대시보드를 자유롭게 커스터마이징할 수 있다는 점이 결정적이었습니다.
대시보드를 계속 들여다보고 있을 수는 없으니, AI 에이전트 워크플로우에 관한 경보도 함께 세팅해뒀습니다. Tempo 자체가 죽었는지, span 수집과 지표 반영 사이가 끊기지는 않았는지, 여러 워크플로우가 동시에 실패하는 플랫폼 장애인지, 특정 워크플로우가 지속적으로 실패하는지, RAG 검색이 조용히 실패하고 있는지를 각각 감시합니다. J은행 요구사항에서 "로그화면 제공"으로만 뭉뚱그려져 있던 Agent 노드 실행 오류 감지, MCP 도구 실행 실패 감지, 워크플로우 실행 실패 감지 항목들이 이 대시보드와 경보로 비로소 구체적인 형태를 갖춘 셈입니다.
마치며
여기까지가 프로젝트에서 마주한 질문, 즉 "어느 노드가 느렸는지, 어느 노드에서 실패했는지"에 답하기 위해 걸어온 과정입니다. Zero-code Instrumentation으로 기본 배관을 깔고, 그 위에 OTel SDK로 워크플로우·노드 단위 span을 직접 열어 도메인 경계를 얹었습니다. 실제로 붙이는 과정에서는 auto-instrumentation과의 역할 충돌, context가 끊기는 지점들, 생명주기 관리처럼 설계 단계에는 없던 디테일들을 하나씩 걷어내야 했고, 마지막으로 Grafana Tempo 위에 대시보드와 경보를 얹어 눈으로 확인하고 즉시 알아챌 수 있는 형태까지 만들었습니다.
물론 아직 남은 과제도 있습니다. LLM chat span에는 애초에 오류를 표시하는 경로가 없어 모델 응답 오류를 경보로 걸 수 없었고, 도구 호출 실패는 ReAct 루프의 정상적인 재시도 과정과 뒤섞여 있어 구분이 더 필요했으며, 워크플로우 P95 지연은 Tempo 기본 히스토그램 버킷의 한계 때문에 아직 걸지 못했습니다. 다음 계획은 이 세 가지를 실제로 신뢰할 수 있는 신호로 바꾸는 것입니다.
편집자 의견 · 도입 판단과 운영 합의 — 이 구현을 실제 고객 환경에 적용하려면, 대표 장애 시나리오를 기준으로 ‘실패 지점 식별 → 관련 호출 추적 → 담당자 대응’이 실제로 이어지는지 확인하는 과정이 필요합니다. 이와 함께 정상 재시도와 장애·사용자 취소를 구분하는 기준, 경보 수신·대응 절차, 데이터 보관 기간과 접근 권한, 수집 비용 등 운영에 필요한 기준과 책임 범위도 사전에 정리되어야 합니다. 현재 LLM 오류 경보, 도구 실패 분류, P95 지연 측정 등은 추가 검증이 필요한 영역인 만큼 보장 기능이나 SLA로 보기보다 향후 고도화 과제로 구분하는 것이 적절합니다. 결국 고객에게 중요한 것은 차트나 로그의 양이 아니라, 문제가 발생했을 때 원인을 얼마나 빠르게 찾고 실제 대응과 복구까지 연결할 수 있는가입니다.